三月写三个 AI 编程框架的对比时,我主要关注它们如何组织开发:OpenSpec 管规范,BMAD 管敏捷流程,Superpowers 管开发纪律。半年过去,再沿着这个分类介绍,已经会漏掉不少变化。
八月,我们在Feature Workflow 的优化复盘里讨论过工作流变轻。这次我重新查看三个项目的官方版本记录和工作流文档,想核对一个问题:当模型能自己调查代码、规划实现并修复失败后,这些框架还在增加哪些步骤,又开始删除哪些步骤?
本文的资料截止到 2026 年 10 月 9 日。检索时最新发布为 BMAD v6.12.1、OpenSpec v1.14.0 和 Superpowers v6.4.2。下面挑出影响工作方式的更新,不逐条罗列安装器和兼容性修复。
有一点需要先说明:Superpowers 明确提到了前沿模型带来的行为变化。BMAD 和 OpenSpec 的更新也在减少流程成本、加强执行可靠性,但仅凭版本记录,无法把所有改动都归因于模型升级。文中的设计分析是我的判断,不代表三个项目的官方结论,也不构成它们之间的性能评测。
Superpowers 开始把实现者当成有能力的工程师
计划只记录实现者无法自行决定的内容
我们旧文章介绍 Superpowers 时,写的是“小任务按 2–5 分钟切分,计划包含完整代码”。9 月 25 日的 v6.4.2 改掉了这个要求:代码步骤主要记录签名、文件和规范中的具体值,测试步骤记录断言,函数体通常由实现者完成。步骤粒度改成一个动作及其可检查的结果。v6.4.2 发布说明
这次调整有明确的模型背景。维护者发现,部分前沿模型在写计划时会过度积极,尝试在规划阶段实现整个项目。计划越写越像程序,还可能产生为了确认计划而进行的临时构建。
我觉得这处变化很有代表性。完整代码计划曾经能减少弱模型的自由发挥,但当执行模型已经能根据接口和测试写出实现时,提前生成函数体,就容易把同一份工作做两遍。规划阶段还没有充分运行代码,却先锁定了实现细节,后面遇到真实约束又要重写。
对于强模型,值得在计划里固定的是业务决策:返回值是什么,哪些状态允许转换,兼容哪个接口,哪些依赖不能新增。常规循环、数据结构选择和项目已有的代码模式,可以交给实现者。特殊算法、精确文案或难以推导的行为,仍然需要写清楚。
任务边界要值得一次独立验证
当前 writing-plans skill 要求任务有可独立测试的产出,值得一次 reviewer 检查;配置、脚手架和文档应尽量归入使用它们的任务。计划还保留全局约束、任务输入输出接口和容易漏掉的失败场景。当前计划规范
这给任务拆分提供了比时间更合适的尺度。创建一个文件可能只花几十秒,但单独派发它需要加载上下文、解释目的、收集结果。把一项用户行为拆成十几个这样的任务,协调成本可能超过实现成本。
例如增加搜索结果的空状态,“创建组件”“加样式”“修改引用”可以是内部步骤。只要它们共同产出一个可以验收的页面行为,就没有必要分别启动三个执行上下文。反过来,搜索接口的错误契约如果要供多个调用方复用,即使代码很短,也值得作为明确的协作边界。
减少 reviewer 数量,同时保护审查判断
6 月的 v6.0 把每个任务的两个 reviewer 合并为一个,由它同时给出规范符合性和代码质量结论,再保留最终的全分支审查。diff 和任务说明通过文件传递,审查必须提供位置证据,控制器也不得引导 reviewer 忽略问题或预先降低严重度。v6.0 发布说明
这次变化没有把审查简化成一句“通过”。它减少了重复读取,却收紧了审查关系。一个控制器为了完成任务,可能接受实现者的解释,再把这个解释传给 reviewer;后者如果顺着同一套理由判断,多个 Agent 也可能一起放过缺陷。
我更关注这里的独立性。reviewer 应拿到需求、约束、代码差异和必要上下文,可以自行追查问题。实现者的理由可以作为材料,但不能替代验证。发现规范本身有问题,也应该把矛盾留给决策者处理。
对 Superpowers 的新理解是:它仍然重视 TDD、系统化调试和完成前验证,但开始认真计算每次派发、重复阅读和上下文占用的成本。强模型得到更多实现空间,审查结论则需要更具体的依据。
BMAD 把分散的开发入口收敛到 Build
快速路径成为正式的开发入口
8 月的 v6.11 将 Quick Dev 改为 Build,弃用 create-story → dev-story 配对,正式实施链收敛为 sprint-planning → build → code-review。核心技能从 14 个合并到 8 个,研究与审查能力也整合进统一入口。v6.11 发布说明
这个变化比命令改名更有意义。以前,使用者要先判断进入哪条流程,再理解不同入口之间的关系。现在,执行入口负责承接更多工作,差异可以通过参数和审查视角表达。
角色分工仍然有用,尤其在产品定义、架构权衡和专业测试中。但每一次交接都需要传递决定、约束和进度。如果模型能在同一个执行上下文中完成调查、实现和局部修复,继续为这些动作设置独立入口,就容易产生重复阅读与不同版本的理解。
我认为 BMAD 正在重新划定值得交接的边界。框架保留规划和审查能力,同时让执行过程更集中。技能数量减少本身不说明质量提高,需要看被合并的入口是否曾经反复处理同一份信息。
调查以后再决定流程深度
9 月的 v6.12 明确要求 Build 在调查变更后决定流程深度。简单改动使用两个部分的 spec,可以在一个 session 内结束;格式调整和 Git 日常操作等不再自动触发 Build,项目上下文默认自动加载也有所收敛。v6.12 发布说明
这比一开始按需求描述判断大小更可靠。用户说“增加一个字段”,实际可能涉及数据库迁移、历史数据和多个客户端;用户说“重做筛选”,也可能只是复用现成组件。还没读代码就决定完整流程,既可能漏掉风险,也可能给简单改动配上过多文档。
适应强模型的工作流,可以先允许一段有边界的调查,再根据发现决定是否补充设计、拆分任务或升级验证。升级理由应该具体到公共接口、数据一致性和跨模块依赖,方便后续复核。
持续执行需要可以恢复的状态
7 月的 v6.10 加入可选的 bmad-loop 模块,用于无人值守开发编排;当时的 bmad-dev-auto 依据 spec frontmatter 状态完成创建或恢复规范、实现、审查和收尾。8 月对应入口改名为 bmad-build-auto。v6.10 发布说明
这里的价值在于把下一轮执行需要知道的信息落到文件里。模型可以自行决定局部实现路径,编排器仍然要知道任务是否完成、是否需要再次审查、哪里需要人处理。一次会话结束后,这些信息不能跟着上下文消失。
自动循环也会放大状态错误。一个失败任务被误标为完成,就可能释放下游依赖;一个已经处理过的问题缺少处置记录,就可能在下一轮反复出现。流程入口收敛以后,状态转移和问题记录反而更需要确定性处理。
因此,我现在会把 BMAD 理解为仍然覆盖完整生命周期、但主动缩短常规执行链的框架。它开始让调查结果决定流程,让状态支撑持续执行。多角色数量已经不足以解释它的设计重点。
OpenSpec 在补齐规范与实际执行之间的缝隙
先读代码,再写规划产物
OpenSpec 的 OPSX 和 propose → apply → archive 在我们三月的文章里已经出现,不能当成这半年的新增功能。近期更值得看的是 v1.12:propose 和 fast-forward 在起草产物前检查相关代码、测试与文档,Explore 先查仓库,再询问用户。v1.12 发布说明
这能降低两类规划错误。一类是根据常见技术栈想象方案,忽略项目已有实现;另一类是把代码里已有的事实重新抛给用户,让人代替 Agent 做调查。
例如增加登录限制,Agent 应先看已有认证入口、错误处理和测试约定,再提出变更。哪些业务限制需要用户决定,可以明确询问;现有路由放在哪里,则应该自己找到。模型的调查能力越强,规范越应该贴近当前仓库,而通用模板只负责提醒哪些决定还没有回答。
把差异和进度做成可以读取的数据
v1.11 增加了规范变更的 diff 展示和全部活动变更的批量状态,支持 JSON;v1.14 的看板进一步展示产物的完成、就绪、阻塞和跳过状态。v1.11 发布说明、v1.14 发布说明
规范变长以后,人不容易看出究竟改了什么,Agent 也可能把整份规范再次读入上下文。精确 diff 把注意力集中在决策变化上;结构化状态则让编排器少做一次自然语言推断。
我把这看作工作流中的职责分配:需要理解业务的部分交给模型,可以精确计算的部分交给工具。当前文档也明确由 AI 驱动工作,CLI 提供确定性的目录结构、状态和产物指令。实现中发现新情况,允许更新规划产物;额外的 Explore 和 Verify 仍是可选路径。工作流文档
这也提醒我们,不能把 OpenSpec 当成自带全部质量门的开发流水线。规范管理、代码正确性和发布就绪是不同问题,项目仍然要配置自己的测试与交付条件。
完成标记必须对应实际变化
v1.13 开始提示“已有任务,但没有 delta specs”的不一致,并修复解析与归档漏掉规范内容的问题。v1.14 则让 Apply 检查准确的任务复选框,在规范同步遇到阻塞时停止归档。v1.13 发布说明、v1.14 发布说明
这些看起来像细小修复,却涉及工作流能否相信自己的完成记录。任务打了勾,不代表规范已经同步;归档命令返回成功,也可能只是文件移动完成。只要其中一个环节误报,后续 Agent 就会基于错误的项目事实继续开发。
我的理解是,OpenSpec 继续保持规范管理的定位,近期更多精力放在规划依据、状态可见性和同步可靠性上。它没有提供“强模型可以不要规范”的证据,反而说明 Agent 越能持续推进,外围系统越需要防止虚假的完成状态。
三个项目在减少不同的成本
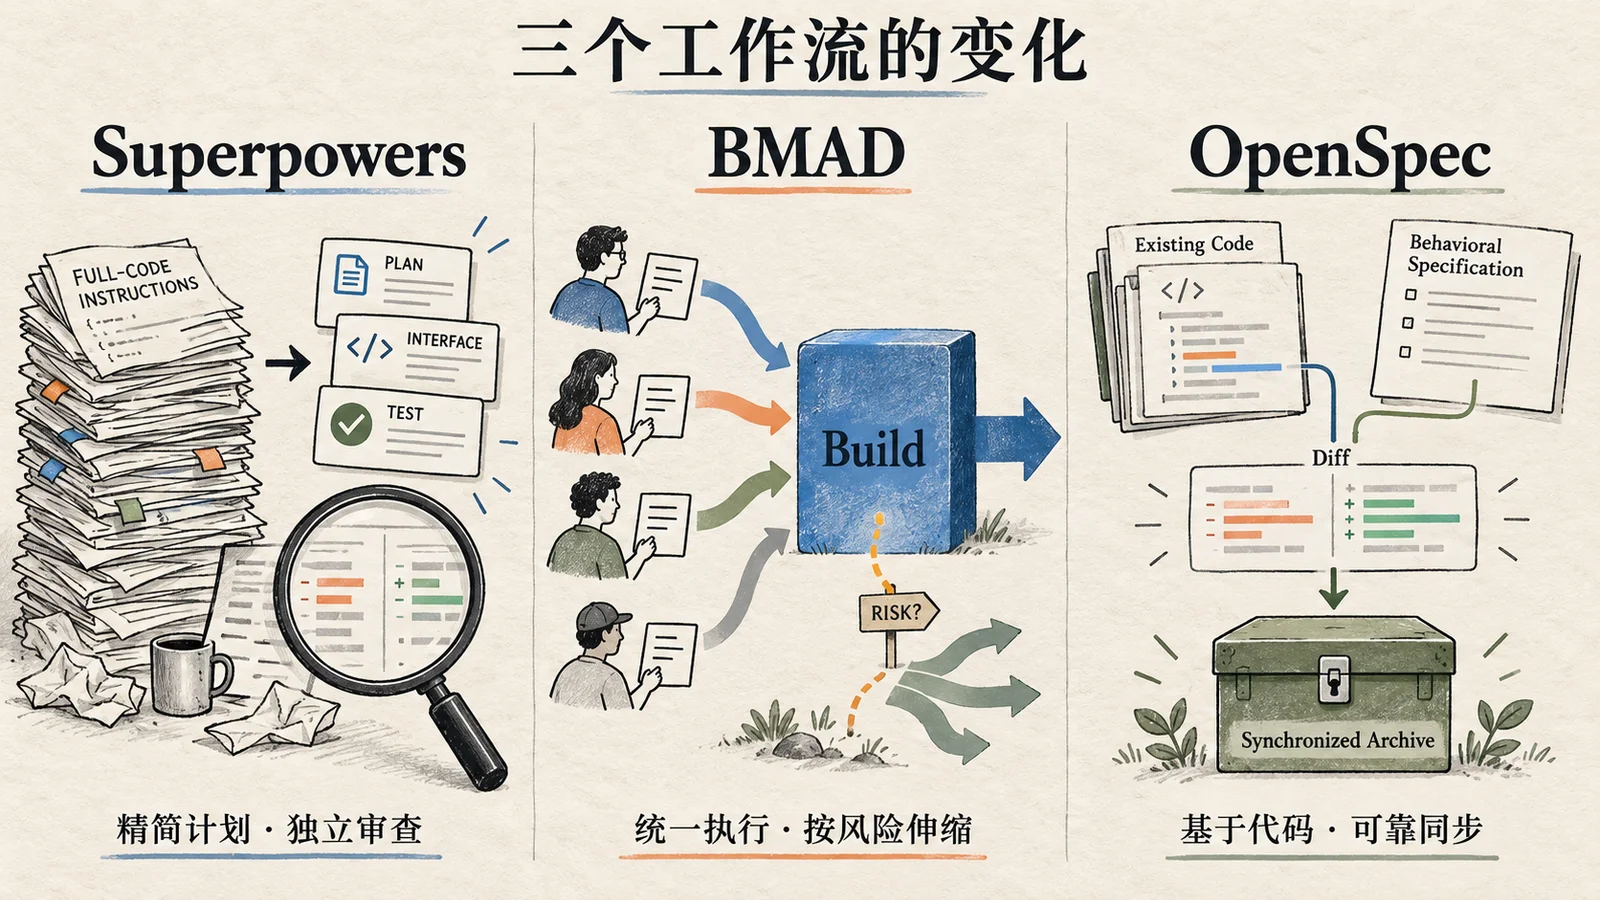
把更新放在一起,可以看到一些相似方向,但它们没有变成同一种工作流。
| 项目 | 正在减少的成本 | 仍然需要外置的信息 | 对工作流设计的启发 |
|---|---|---|---|
| Superpowers | 完整代码计划、重复审查、昂贵上下文占用 | 精确约束、接口、测试与审查证据 | 把任务交给有能力的实现者,并保护审查判断 |
| BMAD | 分散入口、Story 交接、预先决定的流程深度 | 生命周期状态、升级理由、问题处置 | 调查后选择流程,让统一执行入口承接更多工作 |
| OpenSpec | 脱离代码的规划、整份规范重复阅读、状态猜测 | 行为规范、差异、产物状态和同步结果 | 让模型推进工作,让工具维护可核实的事实 |
对我来说,这些改动共同支持了一个判断:模型能力提升后,原来为弥补实现能力不足设置的步骤,需要重新检查。跨任务约束、验证结果、恢复状态和副作用授权,仍然需要工作流管理。
同时,更强的模型也会制造新的问题:规划过度、主动扩大实现范围、用解释说服 reviewer。工作流要随着实际失败模式调整,不能只按模型排行榜决定删掉多少约束。
Feature Workflow 可以在已有优化上继续往前走
我们自己的工作流已经走过一次类似调整。v3 的架构复盘重点解决隔离执行和完整生命周期;八月的优化文章则记录了 Lite/Deep 路由、上下文按需加载、状态源收敛和完成硬门禁。
以下已有行为以那篇复盘的记录为依据,本次没有重新验证工作流代码。后面的改动是下一步建议,也没有在本文发布时同步实现。
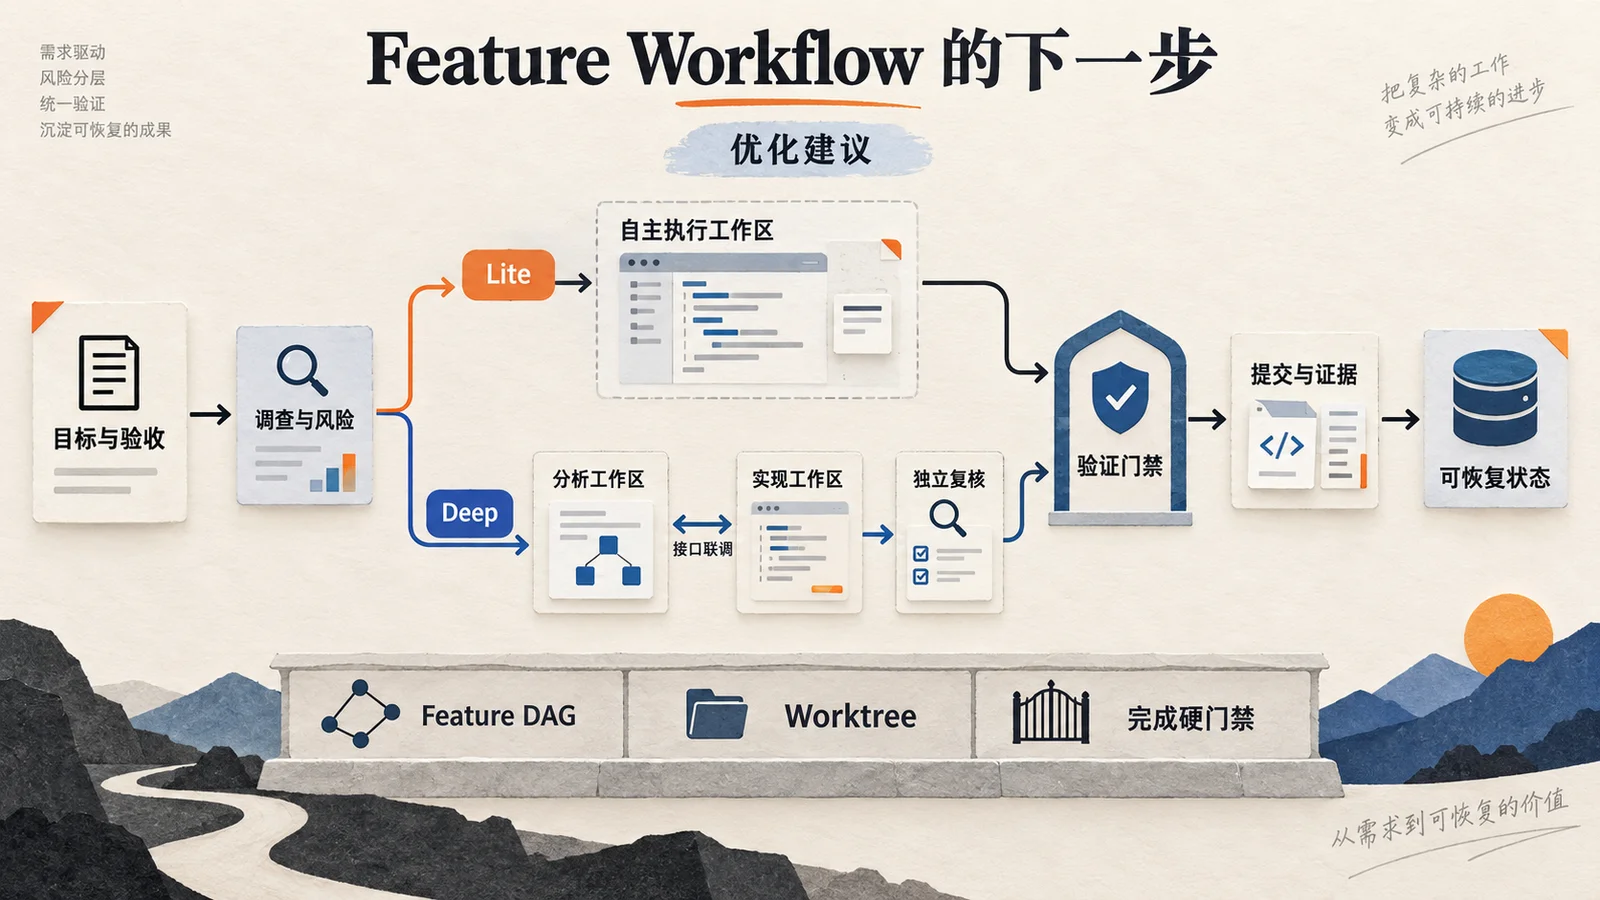
保留 Feature 的交付边界,放宽内部计划
按用户价值切分、用依赖 DAG 调度、用 Worktree 隔离执行,这些原则仍然有用。需要重新校准的是 Feature 内部到底拆多细,以及拆分后是否值得增加一次上下文交接。
八月的优化已经让 Lite 成为默认路径,task.md 可以根据实际代码动态维护,充实规约、深读历史和规格审查按风险启用。结合 Superpowers 的变化,我建议进一步约束计划的内容:保存业务决定、接口、不可变条件和验证方法;普通实现细节留在代码中。
例如“用户可以撤销一条草稿订单”,计划需要写明哪些订单可撤销、撤销后关联数据如何处理、重复请求返回什么、用什么测试证明。Service 中的常规实现,遵循现有模式即可。
Feature 也不能仅因模型上下文变大就无限扩大。能独立验收、失败后能单独恢复、跨边界接口清晰,才适合成为一个交付单元。Worktree 解决文件工作区隔离,共享数据库、端口和最终合并的兼容性仍要单独处理。
用调查结果决定 Lite 和 Deep
已有 Lite/Deep 设计可以继续保留。下一步值得补强的是路由依据:启动时先做有限调查,把发现的风险写入 risk_signals,再选择执行深度。
如果实现中发现公共接口变化、共享数据迁移或新的跨模块依赖,应允许从 Lite 升级到 Deep,记录升级原因和待决策事项。升级不需要重做此前已验证的全部工作,只补足新风险对应的设计和检查。
下面是建议记录的例子,不是现有字段格式的声明:
execution_mode: deep
risk_signals:
  - public_api_change
  - shared_database_migration
route_reason: 调查发现旧客户端依赖现有响应字段
required_checks:
  - api_compatibility
  - migration_rollback
这样,“选择了 Deep”有可以复核的理由。它也让我们知道某个额外步骤究竟在处理什么风险,后续才有依据判断是否可以简化。
收敛状态源,同时把证据绑定到提交
八月复盘已经明确:队列负责业务状态,Git 负责代码状态,归档保存交付结果,临时调度状态尽量短生命周期。下一步不需要再增加一个平行状态文件,可以扩展现有验证记录,保存验证针对的代码版本和需求版本。
一个 Feature 在分支上通过测试,合并或修复冲突后,代码已经变化。此前的证据只能证明此前的版本。完成校验应检查证据是否适用于当前待交付提交,变化后重跑受影响的验证。
也要防止同一个 Feature 被重复派发。建议由确定性脚本领取任务,并校验合法状态转移、执行所有者和当前版本;中断恢复时重新核对代码与证据。这里增加的是执行协议的可靠性,模型仍然决定如何搜索、实现和修复。
按风险选择审查,保留每个问题的去向
我们的完成硬门禁已经要求缺少证据或存在阻断项时拒绝完成。可以继续补上一层问题处置:每个 finding 保留编号、位置、证据,以及修复、接受风险或不成立的结论。后两种结论要有理由,重要风险应由相应决策者处理。
低风险小改动可以由主 Agent 执行并运行必要检查;公共 API、权限和数据迁移等改动,值得增加独立审查。拆成多个 Feature 的工作,还应在集成后检查接口衔接和用户端到端行为。
独立 reviewer 应直接读取规范、约束和 diff。调度器可以描述审查范围,但不能替它预设问题严重度,也不能通过改写验收条件消除阻断项。自动模式仍然要遵守同一套完成条件。
更强的模型可以做更复杂的动作,但执行授权仍然需要独立判断。是否允许合并、远程推送或生产变更,应由已有授权和项目策略决定,模型能力升级不会自动扩大这些权限。
用交付结果检验工作流是否值得保留
“工作流变轻”需要验证。建议在同一批有代表性的 Feature 上,比较调整前后的首个有效改动耗时、端到端交付时间、token 消耗、人工介入次数、返工和交付后缺陷,并记录模型、运行环境与工作流版本。
评估尤其需要覆盖中断恢复、接口变更、迁移失败和合并冲突。小型 CRUD 顺利完成,无法证明状态恢复和质量门可靠。删除一个步骤后如果经常返工,可能需要把它恢复到特定风险路径;如果少了两次文档交接,结果和恢复能力仍然稳定,就可以保留这个简化。
对我们现阶段最有价值的借鉴,我会按下面的顺序落地:先精简计划内容,再补强调查后的风险路由,然后绑定验证证据与提交,最后用问题处置和代表性任务评估检查效果。Feature DAG、隔离执行和已有完成硬门禁继续作为底座。
下一次复盘,我更想看这些调整有没有减少等待和返工,以及中断后能否准确继续。只有这些结果改善,工作流的简化才算完成。